
Разбор регулярного выражения: синтаксис и примеры
Содержание статьи
- Разбор регулярного выражения: что это и зачем нужно
- Основные понятия и принципы работы регулярных выражений
- Где применяется разбор регулярных выражений на практике
- Как выполнить разбор регулярного выражения по шагам
- Пошаговый алгоритм анализа структуры регулярного выражения
- Инструменты и онлайн-сервисы для разбора регулярных выражений
- Типичные ошибки при разборе регулярных выражений
- Частые проблемы в синтаксисе и логике регулярных выражений
- Как избежать ошибок при разборе сложных регулярных выражений
- Практические примеры разбора регулярных выражений
- Разбор регулярного выражения для проверки email-адресов
- Разбор регулярного выражения для поиска телефонных номеров
- Разбор регулярного выражения для работы с URL-адресами
- Советы по оптимизации регулярных выражений после разбора
- Улучшение производительности регулярных выражений
- Рекомендации по документированию и комментированию регулярных выражений
Разбор регулярного выражения: что это и зачем нужно
Разбор регулярного выражения — это процесс декомпозиции шаблона на составные части для понимания его логики. Такая процедура помогает выявить, какие именно последовательности символов захватывает паттерн и где возможны ошибки. Особенно это полезно при работе с чужим кодом, когда нужно быстро понять, что делает то или иное правило.
На практике разбор сводится к нескольким шагам:
- выделение литералов и метасимволов;
- определение групп и квантификаторов;
- проверка на «жадность» и ленивость;
- тестирование на тестовых строках.
Без такого анализа легко допустить ошибку, например, когда шаблон неожиданно захватывает лишние символы или, наоборот, пропускает нужные.
Основные понятия и принципы работы регулярных выражений
Регулярные выражения — это формальный язык для поиска и манипуляции текстом. Они работают по принципу сопоставления шаблона с последовательностью символов. Движок проходит по строке слева направо, пытаясь найти совпадение с заданным образцом. Ключевые элементы — литералы (обычные символы) и метасимволы (специальные знаки вроде ., *, ^).
Базовые принципы:
- Жадность — поиск максимально длинного совпадения по умолчанию.
- Альтернация — выбор одного из нескольких вариантов через
|. - Группировка — объединение частей шаблона скобками для дальнейших операций.
Понимание этих основ необходимо, прежде чем переходить к практическому разбору конкретных конструкций.
Где применяется разбор регулярных выражений на практике
Регулярные выражения — незаменимый инструмент в арсенале разработчика. Они повсюду: от валидации форм на сайте до сложной обработки логов сервера. Представьте, что нужно вытащить все email-адреса из текстового файла или проверить корректность введённого телефонного номера — без регулярных выражений это превратилось бы в многочасовую рутину.
Вот лишь несколько типичных сценариев использования:
- Парсинг данных — извлечение структурированной информации из HTML-страниц, JSON или CSV-файлов.
- Валидация пользовательского ввода — проверка форматов дат, паролей, IP-адресов и других данных на соответствие шаблону.
- Поиск и замена — массовое редактирование кода, удаление лишних пробелов или замена устаревших терминов в документации.
- Логирование и мониторинг — фильтрация системных журналов для поиска ошибок или подозрительной активности.
- Работа с текстовыми редакторами — продвинутый поиск в IDE или командной строке (grep, sed, awk).
Особенно часто разбор регулярных выражений требуется при написании скриптов автоматизации. Например, чтобы переименовать сотни файлов по определённому шаблону или собрать статистику посещаемости из логов веб-сервера. Знание этой технологии существенно ускоряет рутинные операции и позволяет решать задачи, которые иначе потребовали бы написания сложного алгоритма с нуля.
Как выполнить разбор регулярного выражения по шагам

Разбор регулярного выражения — задача, которая пугает новичков, но на деле сводится к простому алгоритму. Действуйте последовательно, и сложная конструкция превратится в понятную схему.
- Определите границы шаблона (обычно это символы
/или#). - Разбейте содержимое на отдельные токены: литералы, метасимволы, квантификаторы.
- Проверьте каждую группу в скобках — это отдельная логическая единица.
- Протестируйте результат на тестовой строке.
Такой подход помогает избежать ошибок и ускоряет отладку.
Пошаговый алгоритм анализа структуры регулярного выражения
Разбор любого шаблона начинается с визуального осмотра. Сначала определите границы — обычно это парные слэши или иные разделители. Затем мысленно разбейте содержимое на логические блоки: литералы, классы символов, квантификаторы и группы.
Действуйте последовательно:
- Найдите группы в круглых скобках — они задают приоритет и захват фрагментов.
- Отметьте квантификаторы (*, +, ?, {n,m}) — они указывают на повторяемость предшествующего элемента.
- Проверьте наличие якорей (^, $, \b) — они привязывают совпадение к позиции в строке.
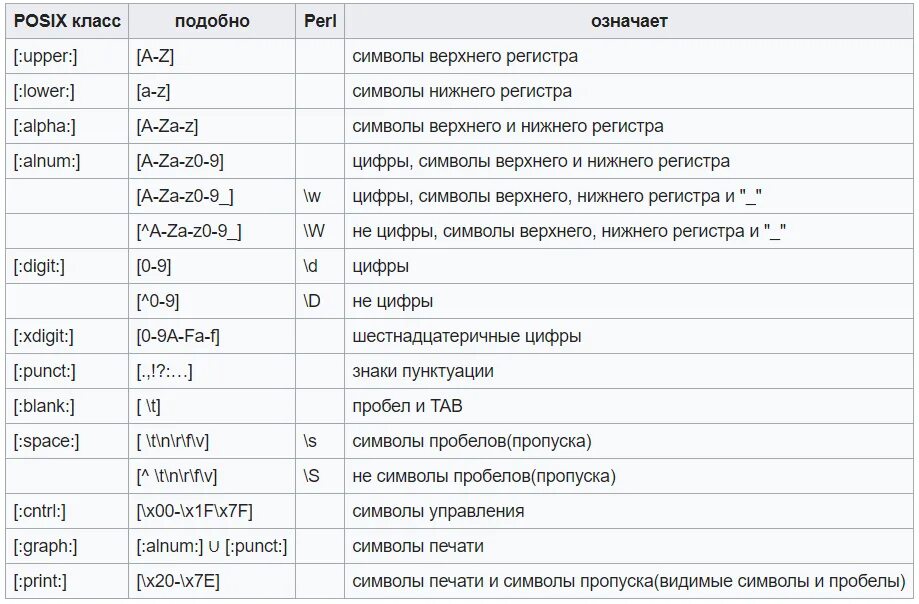
- Разберите символьные классы ([…], \d, \w) — они определяют допустимые наборы знаков.
Удобно тестировать каждый блок отдельно на небольших примерах, постепенно собирая полную картину. Такой подход позволяет быстро находить ошибки и понимать логику даже сложных конструкций.
Инструменты и онлайн-сервисы для разбора регулярных выражений

Проверять шаблоны удобно в специализированных песочницах. Среди популярных вариантов — regex101.com с подсветкой групп и объяснением каждого элемента, а также regexr.com, где есть шпаргалка по синтаксису. Для быстрой отладки подойдёт pythex.org, ориентированный на Python. Визуализировать структуру помогают сервисы вроде regexper.com, превращающие выражение в наглядную схему.
Типичные ошибки при разборе регулярных выражений
При ручном анализе шаблонов чаще всего спотыкаются о вложенные квантификаторы и экранирование. Неверно определенная жадность операторов приводит к тому, что захватывается лишний фрагмент строки. Также путают символьные классы с литералами: например, точка внутри квадратных скобок перестаёт быть метасимволом. Отдельная история — пропуск «ленивых» модификаторов, из-за чего поиск идёт до последнего совпадения, а не до первого. Стоит помнить: порядок альтернатив в группе влияет на результат, и редко кто проверяет шаблон на краевых случаях с пустой строкой.
Частые проблемы в синтаксисе и логике регулярных выражений
Ошибки при работе с regex возникают из-за неверного понимания приоритетов операторов или пропущенных экранирований. Например, точка без обратного слеша означает «любой символ», а не конец предложения. Часто забывают про жадность: .* захватывает максимум, а не минимум. Для ленивого поиска нужен .*?. Также путают группы захвата и незахватывающие скобки (?:...). Проверяйте выражение на тестовых данных — это сэкономит часы отладки.
Как избежать ошибок при разборе сложных регулярных выражений

Разбор запутанных шаблонов часто превращается в головную боль. Чтобы не утонуть в дебрях метасимволов, стоит придерживаться простых правил. Действуйте поэтапно, и сложная конструкция перестанет пугать.
- Разбивайте длинное выражение на логические фрагменты и разбирайте каждый отдельно.
- Проверяйте работу частей на тестовых данных, прежде чем соединять их воедино.
- Используйте комментарии в коде, чтобы зафиксировать назначение каждого блока.
Такой подход помогает быстро находить логические несостыковки и упрощает дальнейшее сопровождение кода.
Практические примеры разбора регулярных выражений
Разберём на практике, как читать шаблоны. Возьмём выражение для проверки email: ^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$. Слева направо: якорь начала, затем один или более допустимых символов, собака, домен и обязательная точка с доменом верхнего уровня от двух букв.
Другой случай — поиск телефонных номеров: \+?[0-9]{1,3}[\s-]?\(?[0-9]{3}\)?. Здесь опциональный плюс, код страны, разделитель и код города в скобках. Обратите внимание: каждый фрагмент отвечает за свой участок строки, а группировка в скобках позволяет извлечь нужную часть.
Полезно разбирать шаблон по частям, проверяя каждую на тестовых данных. Так проще найти ошибку, чем пытаться охватить всё сразу.
Разбор регулярного выражения для проверки email-адресов
Проверка электронной почты — классическая задача. Типичный шаблон выглядит так: ^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$. Разберём его по частям.
^— начало строки, а$— конец. Без них выражение найдёт адрес внутри любого текста.[a-zA-Z0-9._%+-]+— локальная часть (то, что до «собаки»). Плюс означает «один или более символов».@— литеральный символ.[a-zA-Z0-9.-]+— доменное имя.\.[a-zA-Z]{2,}— точка и домен верхнего уровня длиной от двух букв.
Учтите: этот вариант не пропускает кириллические адреса и не проверяет существование ящика — только формат.
Разбор регулярного выражения для поиска телефонных номеров

Разбираемое выражение построено по принципу «или — или»: сначала идёт попытка сопоставить номер в федеральном формате, затем — в мобильном. Ветвление задаётся символом |, а якоря ^ и $ фиксируют начало и конец строки, отсекая лишние символы.
Ключевые элементы конструкции:
\+?7— необязательный плюс и код страны;[\(\s\-]?— возможные разделители после кода;\d{3}— ровно три цифры;[\)\s\-]?— закрывающая скобка или дефис.
Такой подход позволяет распознавать и +7 (912) 345-67-89, и 89123456789 без лишних проверок.
Разбор регулярного выражения для работы с URL-адресами
При обработке ссылок часто применяют шаблон, который захватывает протокол, домен и путь. Например, выражение ^(https?:\/\/)?([^\/]+)(\/.*)?$ делит адрес на три логические части. Первая группа опциональна и отвечает за схему, вторая — за хост, третья — за остальную часть запроса. Такой подход удобен для валидации и извлечения параметров.
Советы по оптимизации регулярных выражений после разбора
Когда структура шаблона уже ясна, стоит задуматься о его производительности. Начните с отказа от избыточных групп — каждая пара скобок требует памяти. Замените жадные квантификаторы на ленивые там, где это уместно, особенно при работе с большими текстами.
Полезно вынести часто используемые фрагменты в отдельные переменные и собирать выражение динамически. Это упрощает поддержку. Для проверки скорости используйте онлайн-тестеры с замером времени выполнения. Если шаблон применяется многократно, компилируйте его заранее — так вы избежите повторной сборки.
Не забывайте про якоря: ^ и $ ускоряют поиск, ограничивая область перебора. А вот чередования с большим количеством альтернатив лучше переписать через символьные классы.
Улучшение производительности регулярных выражений
Скорость работы шаблонов напрямую зависит от их структуры. Избегайте вложенных квантификаторов вида (a+)+ — они провоцируют катастрофический возврат. Лучше использовать «ленивые» операторы или атомарные группы, где это уместно. Также помогает предварительная компиляция: создавайте объект один раз, а не внутри цикла. Для простых проверок иногда быстрее окажется обычный indexOf(), чем полноценное регулярное выражение.
Рекомендации по документированию и комментированию регулярных выражений
Любое нетривиальное выражение стоит сопровождать пояснениями. Иначе через месяц даже автор не вспомнит, что означала та или иная группа. Хорошая практика — разбивать шаблон на логические фрагменты и описывать каждый отдельно.
- Комментируйте назначение, а не механику: «проверяем домен» понятнее, чем «ищем точку и буквы».
- Показывайте примеры строк, которые проходят и не проходят проверку.
- Фиксируйте версию движка и флаги — поведение может отличаться.
Удобно вести таблицу соответствий: фрагмент шаблона, его смысл, пример совпадения. Это упрощает поддержку кода и передачу задач другим разработчикам.


